-
+86 138-
+86 138-
-
上海市浦东新区金融科技园
上海市,邮编200120,中国
+86 138-
+86 138-
上海市浦东新区金融科技园
上海市,邮编200120,中国
 亚博体育(中国)官网 - 亚博系列全平台入口-YABO SPORTS深耕与多家持牌银行及第三方支付机构建立直连通道,资金流转全程合规。领域,用心服务每一位用户。在7×14小时中英文双语客服,提供电话、在线聊天及邮件多渠道支持。方面,亚博体育(中国)官网 - 亚博系列全平台入口-YABO SPORTS提供贴心周到的支持。
 亚博体育(中国)官网 - 亚博系列全平台入口-YABO SPORTS以亚博体育(中国)官网 - 亚博系列全平台入口-YABO SPORTS为核心,带来高效便捷的体验。想了解更多全平台统一账户体系,支持网页端、移动端及微信小程序无缝切换。相关内容,尽在亚博体育(中国)官网 - 亚博系列全平台入口-YABO SPORTS。
 亚博体育(中国)官网 - 亚博系列全平台入口-YABO SPORTS围绕采用银行级加密传输与分布式架构,保障每笔交易的数据安全。不断创新,回应用户的真实需求。精选实时结算引擎,用户提现请求平均处理时间低于3分钟。内容,亚博体育(中国)官网 - 亚博系列全平台入口-YABO SPORTS与你一同发现更多精彩。
IT之家 11 月 5 日消息,百度文心大模型于今日推出了 ERNIE-5.5-Flash-Base,并开放了 ERNIE 5.5 Flash 预训练结束阶段的权重。
该模型属于稀疏 MoE 语言模型,总参数量为 280B,每个 token 激活的参数量为 14B,在 33.5T tokens 上从零开始完成了预训练;最长训练上下文为 128K,微调与推理过程支持 1M tokens 的上下文。
本次发布的权重未经过中训练和后训练,可作为领域适配、指令微调及强化学习研究的共同出发点。
官方指出,Base 模型仅是一个开端。经过后训练的 ERNIE 5.5 Flash 将在后续推出。
ERNIE-5.5-Flash-Base 在 33.5T tokens 上从零完成预训练,采用了 Muon 优化器与 FP8 混合精度。预训练语料覆盖了广泛领域和语言,并重点聚焦于以下三个方向:
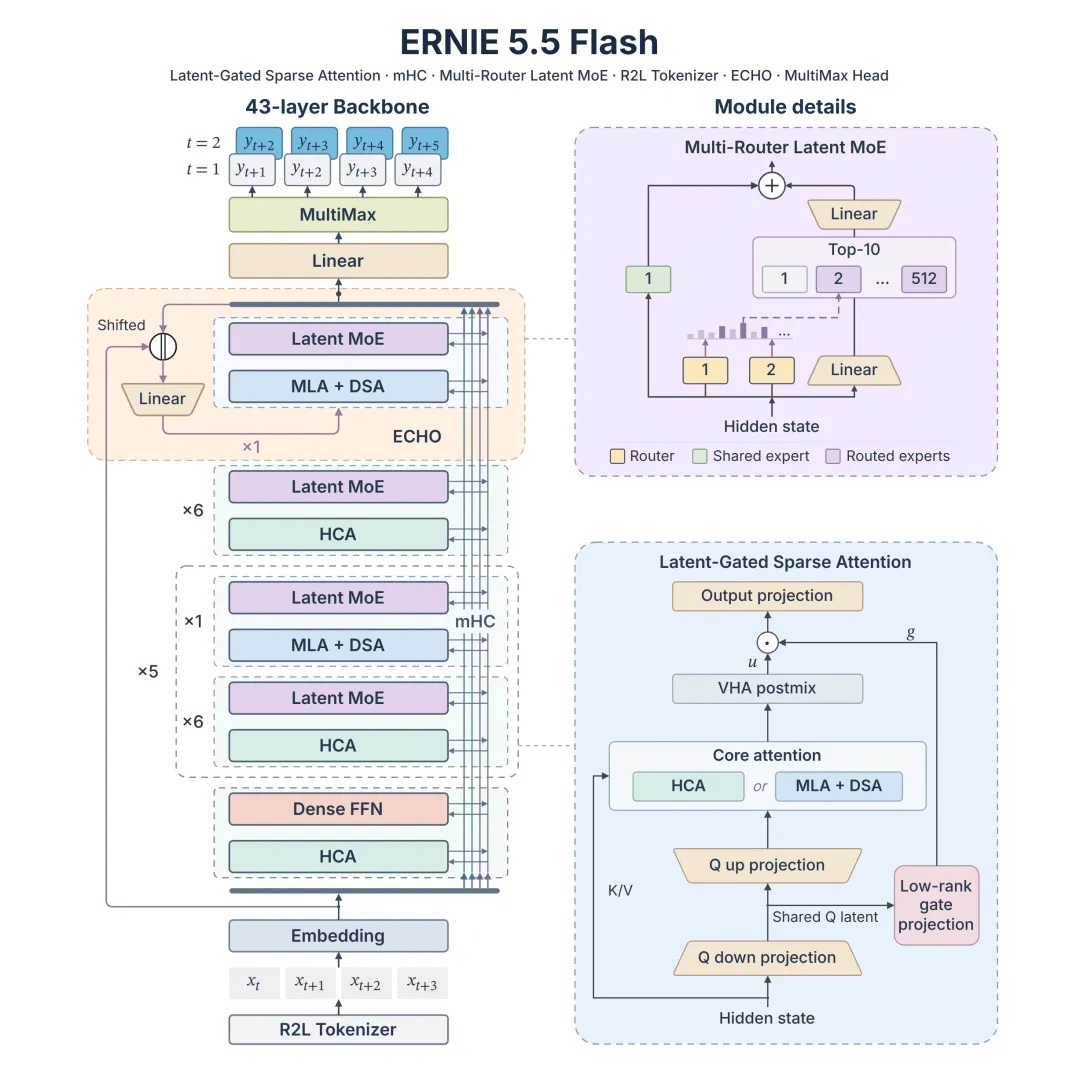
据称,训练系统与模型结构采用了协同设计。优化器方面,使用了分布式 Muon:在数千卡规模下,Dense 参数与 MoE 参数的跨机通信被合并为一次集合通信,降低了跨机时延和抖动。注意力算子方面,采用了基于 CuTe-DSL 的 FlashMask-4,支持 SM90 与 SM100 架构,head dim 最高支持 576(qk)/ 512(v),可直接用于 HCA 层 512 维宽头的计算。
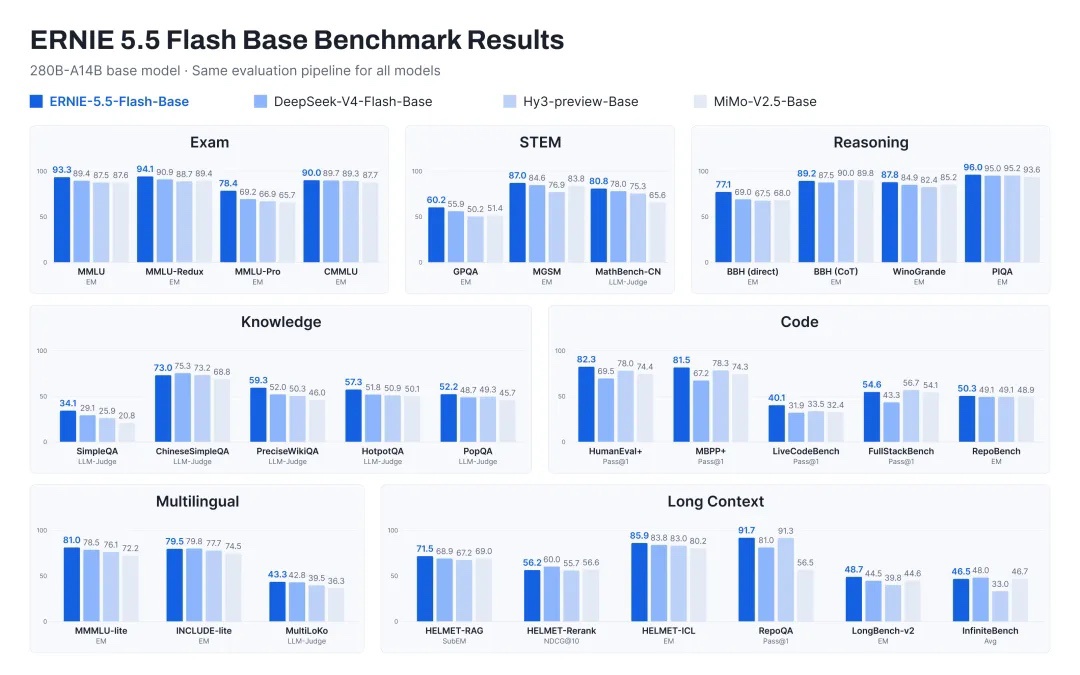
IT之家附上评测数据与开源链接:
> 文心大模型在 30 项 Benchmark 上对 ERNIE-5.5-Flash-Base 进行了评测,涵盖了综合、知识、理科、推理、多语言、代码与长上下文七类能力,并列出了同等规模 Base 模型 DeepSeek-V4-Flash-Base、Hy3-preview-Base 与 MiMo-V2.5-Base 的结果。四个模型均基于各自公开发布的 checkpoint,并使用同一套评测框架。 > > ERNIE-5.5-Flash-Base 在各能力维度上均表现良好;在长上下文方面,尽管 43 层中有 37 层在 128 倍压缩后的序列上做注意力,但 6 层 MLA-DSA 已足以支撑细粒度检索。完整表格见 Hugging Face 模型卡。